 eCommerce
 Sistemas de assinatura
 Chatbot
 Cursos Online
 Agendamento online
 Guia de viagem
 Eventos
 Criadores de Conteúdo
 Entrega local e coleta na loja
 Jornais
 Rádio
 Escolas e Universidades
 Espiritualidade
 Organizações
 Restaurante
 Mercearia
 Crie seu app sob medida
 Comunicação dos Funcionários

 APP BUILDER SEM CÓDIGO
 TECNOLOGIA
 POR QUE GOODBARBER?
 Design
 RECURSOS DO PRODUTO
 TÓPICOS
 REVENDEDOR DE APPS
 DESCOBRIR
Ler, citar, treinar: é você que decide o que as IA fazem com o seu conteúdo
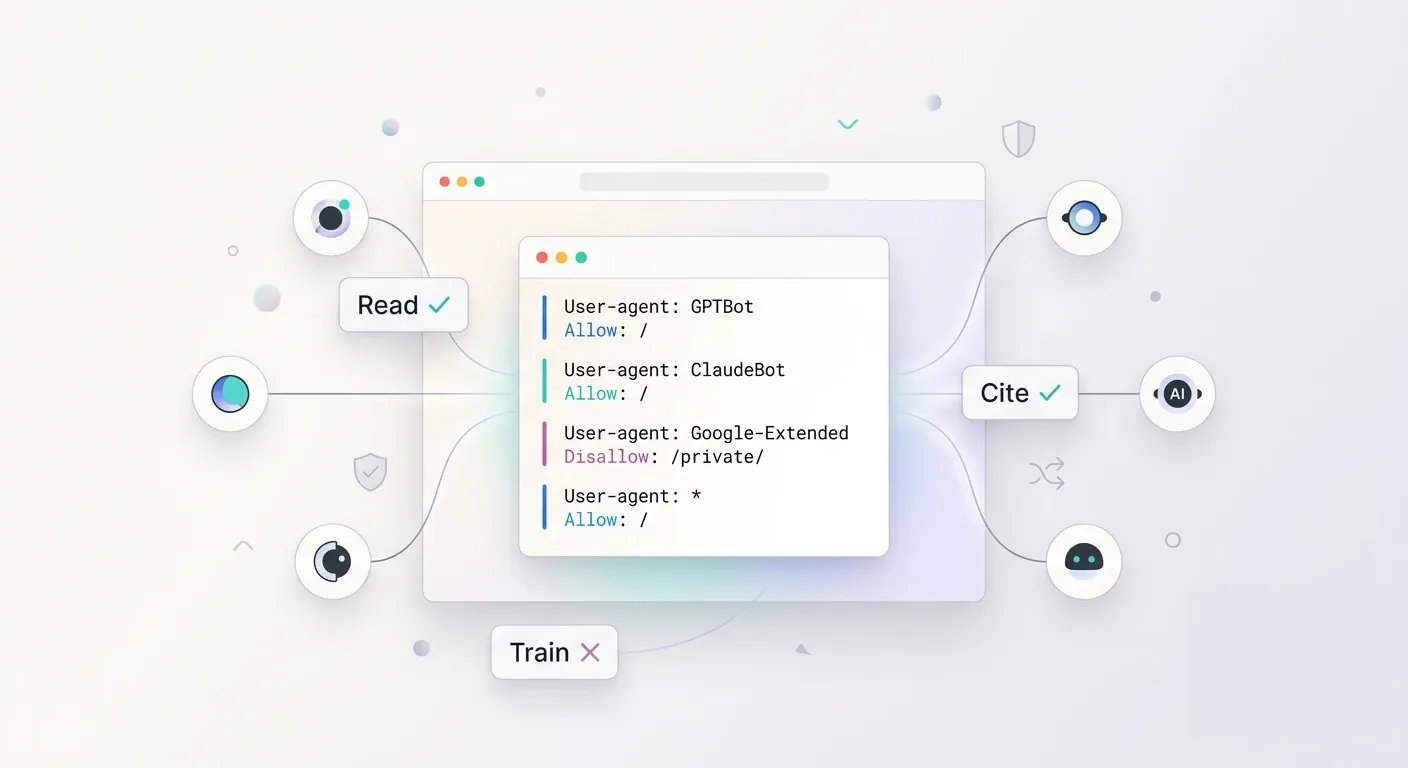
Deixe as IA lerem o seu conteúdo. Treinarem-se com ele é outra decisão. Até agora, o `robots.txt` da sua PWA não distinguia as duas coisas: GPTBot, OAI-SearchBot, ClaudeBot, Claude-SearchBot, PerplexityBot e CCBot recebiam todos a mesma resposta, porque o ficheiro era gerado por si e sem si. Um novo separador ROBOTS.TXT, nas definições de SEO, devolve-lhe essa decisão.
O ficheiro que nunca escreveu responde por si
Se publicou a sua PWA, ela está a servir um robots.txt neste momento: o primeiro ficheiro que um robô lê, e o que decide o que vem a seguir — que partes do seu site são exploradas, e por quem. O seu diz que sim a toda a gente.
Tudo o que se segue diz respeito a essa versão web da sua aplicação. As suas apps iOS e Android não são exploradas por ninguém, e o separador só aparece depois de a PWA ter sido publicada pelo menos uma vez: antes disso não há ficheiro nenhum para configurar.
Era uma resposta defensável. Simplesmente não era a sua — e o público a quem responde mudou. Há uns anos, um robô sobre o seu conteúdo era o Google, o Bing ou um aspirador que lhe era indiferente. Hoje, uma parte crescente desse tráfego pertence a empresas de IA, e não querem todas a mesma coisa das suas páginas. Tratá-las em bloco é escolher entre todas e nenhuma.
O novo separador divide-as em quatro famílias: Search engines (Google, Bing e os outros motores que referenciam o seu site nos resultados), AI answers (ChatGPT, Claude ou Perplexity quando citam o seu site nas respostas), AI training (os robôs que recolhem o seu conteúdo para treinar os seus modelos) e On-demand reading (quando alguém pede a uma IA que abra e leia uma página específica do seu site). Quatro famílias, porque são quatro acordos diferentes.
Ler, citar, treinar: três acordos diferentes
Na prática: a OpenAI envia o GPTBot recolher dados de treino e o OAI-SearchBot responder no ChatGPT Search — este último devolve-lhe leitores. A Anthropic faz o mesmo com o ClaudeBot e o Claude-SearchBot. A Google separa o Googlebot, que alimenta o motor de busca, do Google-Extended, que alimenta os modelos. A Apple separa o Applebot do Applebot-Extended.
Mesma empresa, dois robôs, duas trocas completamente diferentes. Um traz-lhe leitores. O outro leva o conteúdo e não devolve nada. Um sim ou não global não os sabe distinguir; um robots.txt que os nomeia um a um, sim.
É isso que as quatro predefinições traduzem:
- Max visibility — aberto a todos os robôs, incluindo os de treino de IA. Maximiza o alcance. É o seu ficheiro atual, sem alterações.
- No AI training — permite os motores de busca, clássicos e de IA, e bloqueia os robôs de treino de IA. Fica com o tráfego e recusa o conjunto de treino.
- Classic SEO only — permite o Google, o Bing e companhia. Bloqueia todos os assistentes de IA, pesquisa e treino.
- Strict privacy — bloqueia tudo. Para uma aplicação interna ou um ambiente de testes.
Aplica-se uma de cada vez, e pode mudar quando quiser. A maioria dos editores de conteúdo fica-se pela segunda — e é esse o sentido desta funcionalidade: essa escolha era impossível de exprimir até agora.
Veja o ficheiro antes de o publicar
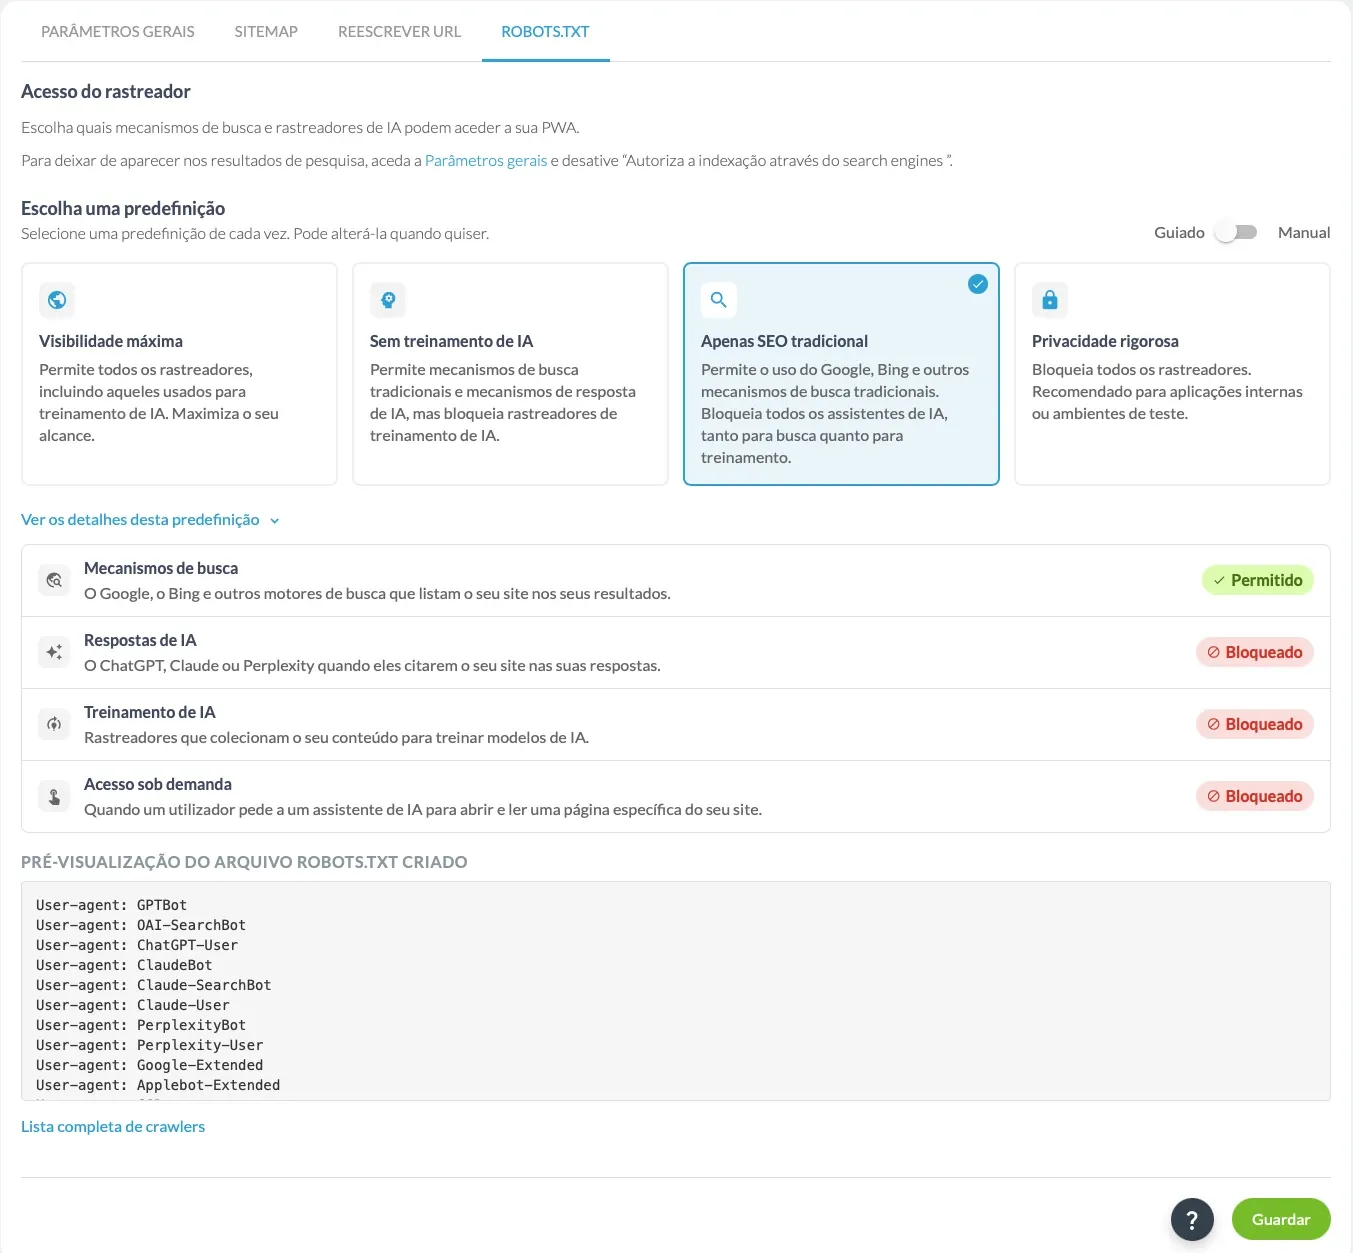
Uma predefinição é um rótulo, e os rótulos lêem-se mal com facilidade. Por isso o separador mostra o seu trabalho.
Abra Ver os detalhes desta predefinição e obtém duas coisas. Primeiro, um veredicto para cada uma das quatro famílias — Permitido ou Bloqueado — para que o compromisso esteja no ecrã e não subentendido num nome. Depois, uma pré-visualização do ficheiro robots.txt gerado, que se atualiza à medida que passa de um cartão para o outro. Valida um ficheiro, não uma promessa.
Por trás desses quatro cartões há um registo de 22 robôs de 15 editores — OpenAI, Anthropic, Google, Apple, Meta, Amazon, Perplexity, Common Crawl, ByteDance, Cohere e outros — com o papel de cada um. Mantê-lo atualizado é trabalho nosso, não seu: quando aparece um novo robô de IA, entra na família certa e a sua predefinição continua a significar o que escolheu. A lista completa dos robôs está a um clique no separador, para quem quiser ver exatamente quem lá está.
Modo Manual, se já fala robots.txt
Existe um segundo modo, e vem com uma condição: destina-se a quem já escreveu um robots.txt.
Passe o interruptor para Manual e as predefinições afastam-se: edita o ficheiro diretamente, uma diretiva por linha. Abre pré-preenchido com as regras da predefinição selecionada, por isso não parte de uma página em branco; a partir daí nomeia os robôs um a um — bloquear o Common Crawl mas manter o GPTBot, abrandar um robô específico com um Crawl-delay, abrir um caminho que de outra forma deixaria fechado. O que escrever é conservado em cada republicação, e a linha Sitemap mantém-se sozinha.
O que é verificado é a forma do ficheiro, não o seu acerto. O conteúdo está limitado a 10 KB, são aceites quatro diretivas — User-agent, Disallow, Allow e Crawl-delay — e tudo o resto é recusado com o número da linha. É um controlo de sintaxe, não uma rede de segurança. Disallow: / é uma linha perfeitamente válida, e tira o seu site inteiro do Google. O editor não o vai impedir, porque não tem como distinguir isso de uma decisão deliberada. A interface avisa-o quando muda de modo, e não é uma formalidade.
Portanto, claramente: se não tem a certeza do que faz uma linha, não a escreva. As quatro predefinições são reversíveis, mostram-lhe o ficheiro antes de o confirmar, e cobrem aquilo de que quase toda a gente precisa. O modo Manual existe para os casos que elas realmente não conseguem exprimir — e se tem um caso desses, já sabe.
O que um robots.txt pode fazer, e o que não pode
Um robots.txt é uma declaração, não uma firewall. É um pedido público que os robôs bem-educados respeitam — e a parte honesta desta funcionalidade é que nem todos o fazem. O ChatGPT-User e o Perplexity-User, que vão buscar uma página porque alguém pediu a uma IA, declaram que não o seguem. O Bytespider também não. O Common Crawl respeita-o apenas em parte. Seguimos esse estado robô a robô em vez de fazer passar o ficheiro por um cadeado: leia a sua escolha como «quem avisei, e de quê», não como «quem parei».
Duas coisas funcionam, essas sim, de forma fiável. Se a sua aplicação aparece ou não nos resultados de pesquisa não se decide aqui: é a definição de indexação das definições gerais, e quando a indexação está desativada o separador afasta-se e diz-lho, em vez de o deixar configurar algo sem efeito. E quando guarda, a cópia em cache servida no seu domínio é purgada imediatamente: as novas regras aplicam-se em segundos, sem esperar que a cache expire por si.
Vá ao seu back office, abra SEO → ROBOTS.TXT, escolha a predefinição que corresponde à sua estratégia de conteúdo e guarde: o ficheiro fica online poucos segundos depois.


