 eCommerce
 Sistemas de assinatura
 RAG Chatbot
 Cursos Online
 Agendamento online
 Guia de viagem
 Eventos
 Criadores de Conteúdo
 Entrega local e coleta na loja
 Jornais
 Rádio
 Escolas e Universidades
 Espiritualidade
 Organizações
 Restaurante
 Mercearia
 Crie seu app sob medida
 Comunicação dos Funcionários


 APP BUILDER SEM CÓDIGO
 TECNOLOGIA
 POR QUE GOODBARBER?
 Design
 RECURSOS DO PRODUTO
 TÓPICOS

 REVENDEDOR DE APPS
 DESCOBRIR
Os agentes de IA leem Markdown? O que dizem duas semanas de logs do nosso próprio servidor
Escrito por Dumè Siacci na
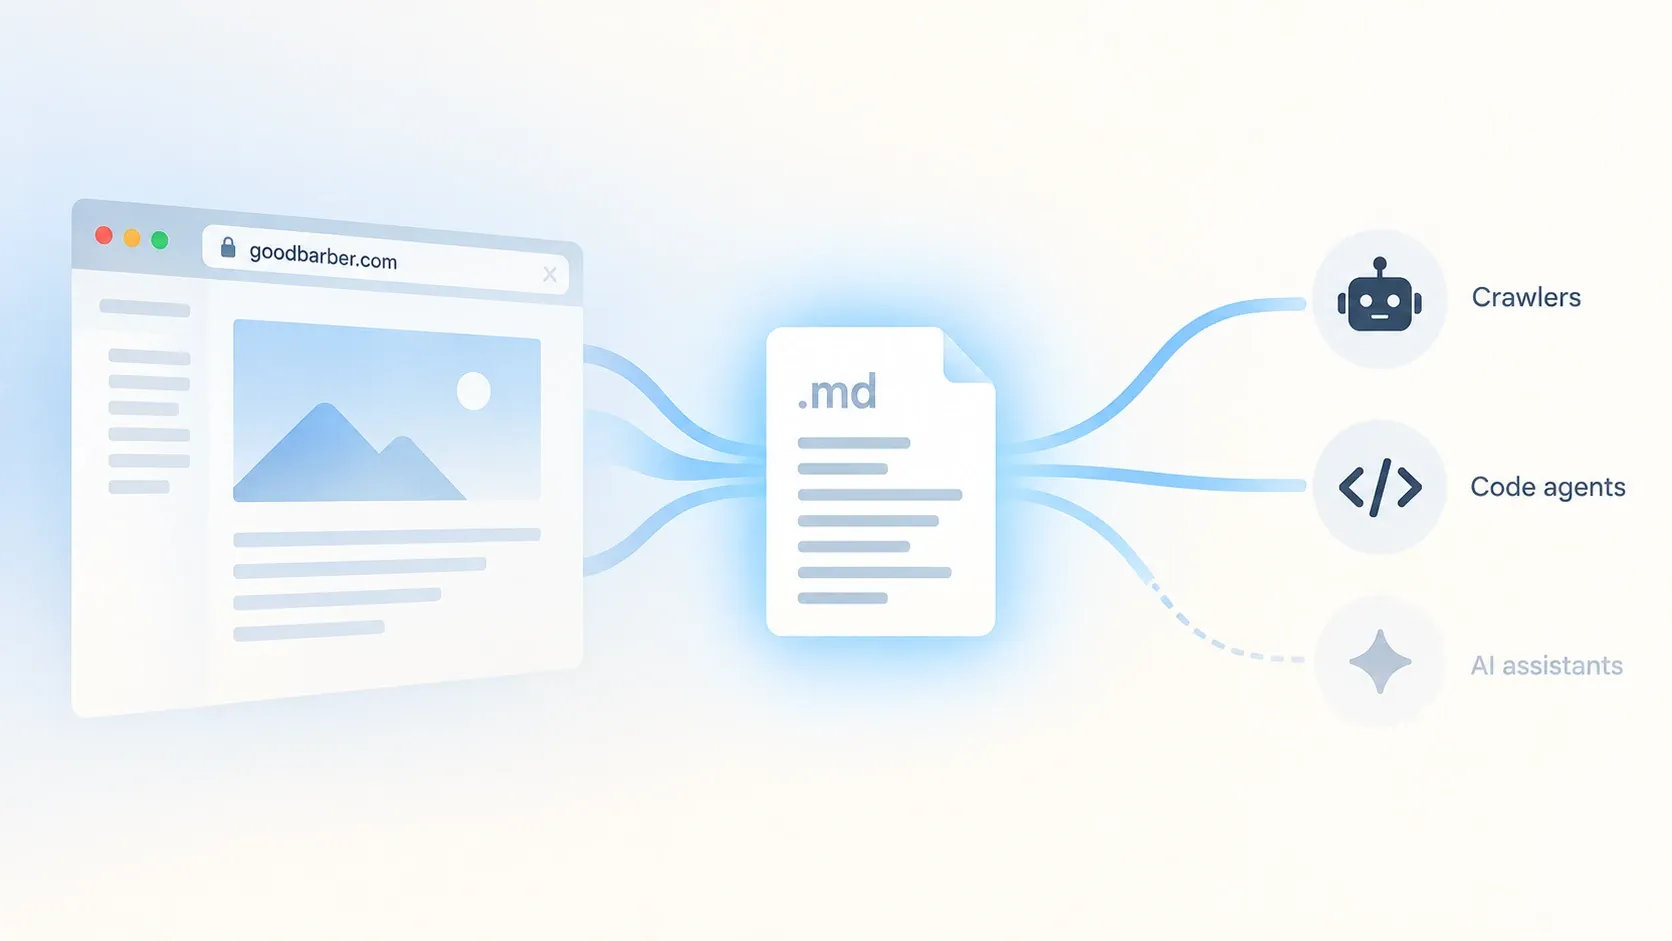
No início de setembro de 2026, demos a cada página do nosso portal comercial, o que você está consultando agora, um gêmeo em Markdown: peça e você recebe a página em texto limpo, em vez de HTML. Depois, lemos os logs. Os rastreadores o pegaram, os agentes de programação o pediram pelo nome, e os assistentes que respondem às perguntas das pessoas o ignoraram por completo. Aqui está o que medimos, com datas, e o que você pode aproveitar para o seu próprio conteúdo.
Under the hood — a engenharia por trás da GoodBarber, explicada para quem administra apps.
Para situar: tudo o que vem a seguir aconteceu no nosso próprio portal comercial, e foi a nossa equipe que colocou isso no ar. O que aprendemos sobre as máquinas que leem páginas da web vale para qualquer conteúdo, o nosso e o seu.
Principais fatos, medidos no nosso portal de 4 a 18 de setembro de 2026:
- Os rastreadores de treinamento e indexação das empresas de IA (Amazon, Meta, OpenAI) leram as páginas Markdown pelo link
.md: cerca de 80.000 solicitações em duas semanas. - Os agentes de programação, com o Claude Code à frente, pedem o Markdown com o cabeçalho
Accept: text/markdowne o recebem: cerca de 22.000 solicitações negociadas, quase todas de mecanismos de resposta criados para agentes e do Claude Code. - O ChatGPT, o Claude na web e o Perplexity, quando respondem a uma pessoa, carregaram o HTML mais de 13.000 vezes e o Markdown uma única vez.
- O rastreador do Google não pediu nenhuma página Markdown.
- O Markdown pesa cerca de 80% menos que a página HTML de onde vem.
Por que servir Markdown aos agentes de IA
A GoodBarber é uma plataforma no-code para criar aplicativos móveis; goodbarber.com é o seu site comercial, em onze idiomas, com páginas de marketing, um blog e uma central de ajuda. Quando alguém pergunta a um assistente de IA se a GoodBarber consegue criar o app que essa pessoa tem em mente, o assistente não lê o nosso folheto. Ele vai buscar as nossas páginas, às vezes milhares por dia, e extrai uma resposta do HTML. HTML é pesado: menus, scripts, layout, banner de cookies. Markdown é o texto da página e nada mais. Servi-lo quando uma máquina pede significa que o assistente lê o conteúdo real, mais rápido, com uma fração do tamanho e menos chance de errar sobre nós.
Em agosto de 2026, Pierre-Laurent tinha contado quem lê o nosso llms.txt. Um llms.txt é um arquivo de texto colocado na raiz de um site, que lista as páginas importantes dele para os sistemas de IA: em quatro meses, nenhum assistente tinha vindo buscá-lo por conta própria. Os mesmos logs mostravam outra coisa: no mesmo período, os assistentes e os seus rastreadores carregaram as nossas páginas comuns 1,6 milhão de vezes. Ninguém lê o mapa; todo mundo anda pelas ruas. A pergunta, então, não era “como fazer com que leiam o índice”, mas “o que entregamos a eles quando chegam”.
Como o nosso portal serve Markdown: negociação de conteúdo e URLs .md
Duas portas, nenhum conteúdo duplicado. A primeira é a negociação de conteúdo, o mecanismo padrão da web pelo qual um cliente informa, na solicitação, o formato que prefere receber: um cliente que envia o cabeçalho Accept: text/markdown recebe a versão Markdown de qualquer página pública, no mesmo endereço. A segunda é um endereço gêmeo: um cliente que acrescenta .md ao endereço de uma página, /pricing.md, /blog/<artigo>.md, recebe a mesma coisa. Esta página também tem o seu gêmeo: acrescente .md ao endereço dela. Cada página HTML anuncia o seu gêmeo com um link padrão, do mesmo jeito que anuncia as suas traduções. O Markdown é gerado a partir do HTML exato que a página já serve, então nunca pode dizer algo que a página não diz, e ele pede aos mecanismos de busca que não o indexem: a página HTML continua sendo a única presente no Google.
Antes de ativar, o teste era verificar se um visitante humano conseguiria notar alguma coisa: respostas comparadas byte a byte com o gêmeo ligado e desligado, em todos os tipos de navegador em que conseguimos pensar, idênticas, a um custo de alguns microssegundos por solicitação.
Não inventamos nada disso. A Cloudflare converte páginas em Markdown na borda da sua rede desde fevereiro de 2026, o Zapier e a Vercel servem as duas portas nos próprios sites. Se você administra um site e quer o mesmo, é um dia de trabalho no servidor, uma biblioteca de conversão, um cache e um jeito de verificar que nada mudou para os humanos. A parte que quase ninguém faz é a seguinte: contar.
Os rastreadores de IA leem Markdown?
De 4 a 18 de setembro de 2026, dois logs dedicados registraram cada solicitação de uma página Markdown, nos nossos sites nos onze idiomas, com o nosso próprio tráfego excluído. Cada “quem” abaixo é um nome declarado, conferido com os endereços IP que o seu operador publica, como Pierre-Laurent tinha feito; quando um operador não publica nada, o nome fica como declarado.
Sim, e são eles que pegam o link .md: cerca de 80.000 solicitações em duas semanas. Metade vem dos rastreadores das empresas de IA, os que montam os conjuntos de treinamento e os índices de busca: os da Amazon, da Meta, da OpenAI, todos a partir dos seus endereços IP publicados. Os rastreadores da OpenAI encontram a versão .md porque a nossa página HTML aponta para ela: em 99 de cada 100 casos, o mesmo rastreador tinha carregado a página HTML nos dez minutos anteriores. O rastreador do Bing também veio, mas passou a maior parte da visita nas nossas páginas de busca interna, que respondem a qualquer consulta que alguém digite. Já o rastreador do Google não pediu nenhuma página Markdown.
Os agentes de programação enviam Accept: text/markdown?
Sim, quase sistematicamente. O cabeçalho recebeu cerca de 22.000 solicitações, um quarto das do link, e de um público diferente. Quase tudo vem de dois mecanismos de busca criados para agentes de IA, ShapBot e ExaSearchBot, e de um único agente de programação: o Claude Code, a ferramenta que desenvolvedores, e não só eles, rodam na própria máquina. O Claude Code enviou o cabeçalho em praticamente cada uma das suas cerca de 1.400 solicitações de página e recebeu Markdown em 98 de cada 100 vezes, três quartos delas na nossa central de ajuda. Isso é coerente com o que a Checkly mediu em fevereiro de 2026: Claude Code, Cursor e OpenCode enviam o cabeçalho; Codex, Gemini CLI, Copilot e Windsurf, não.
ChatGPT, Claude e Perplexity carregam Markdown?
Não, por nenhuma das duas portas. Esse é o número em que teríamos apostado errado. Em duas semanas, as solicitações feitas porque alguém perguntou algo ao ChatGPT carregaram mais de 10.000 das nossas páginas HTML e uma única página Markdown, três minutos depois de entrar no ar, muito provavelmente um de nós fazendo um teste. O Claude na web: cerca de 2.700 páginas HTML, zero Markdown. O Perplexity: cerca de 900, zero. Eles carregam a página HTML e fazem a limpeza por conta própria. Nada do que servimos muda isso.
Quem lê o quê, e para quê:
| Agente (declarado) | O que faz com a página | HTML | Link .md | Cabeçalho Accept |
|---|---|---|---|---|
| Amazonbot, Meta-ExternalAgent | coleta dados para treinamento | sim | sim, por conta própria | não |
| ClaudeBot | coleta dados para treinamento | sim | sim, cerca de quatro .md para cada dez páginas HTML | não |
| GPTBot | coleta dados para treinamento | sim | sim, seguindo o link da nossa página | não |
| OAI-SearchBot | monta o índice de busca do ChatGPT | sim | sim, seguindo o link da nossa página | não |
| PerplexityBot | monta o índice do Perplexity | sim | não | não |
| Bingbot, Applebot, Baidu | índice de busca clássico | sim | sim (o Bing, sobretudo nas páginas de busca) | não |
| Googlebot | índice de busca clássico | sim | não | não |
| ShapBot, ExaSearchBot | índice para as respostas de agentes de IA | sim | não | sim, em quase todas as solicitações |
| Claude Code | agente de programação, busca sob demanda | sim | não | sim, em praticamente todas as solicitações |
| ChatGPT-User, Claude-User, Perplexity-User | carrega uma página para responder à pergunta de uma pessoa | sim | não (uma solicitação em duas semanas) | não |
Dois fatos menores. O Markdown pesa cerca de 80% menos que a página HTML de onde vem, perto de 85% na central de ajuda. E antes de servirmos qualquer Markdown, os nossos logs já guardavam cerca de 900 solicitações a endereços .md que não existiam, README.md, agents.md, CLAUDE.md, tentados por ferramentas que esperam que um site seja um repositório de código; uma delas tinha adivinhado os endereços exatos que publicamos um mês depois.
O que isso muda para o seu conteúdo
Três coisas, tiradas dos nossos logs, e não dos slides de quem quer que seja.
O seu HTML é o que os assistentes leem. ChatGPT, Claude e Perplexity carregam a página que uma pessoa vê. Uma página limpa, atualizada e bem estruturada é o que chega até eles; um gêmeo em Markdown, não, pelo menos não hoje. Pierre-Laurent escreveu como corrigir o conteúdo que os assistentes citam quando eles erram sobre o seu negócio; esse trabalho é feito no HTML, e é ele que compensa.
Os rastreadores seguem os links que você publica. Os rastreadores da OpenAI pegaram o link .md porque a página o oferecia. Se você aponta um caminho para os rastreadores, eles seguem. É também por isso que um llms.txt ainda vale a pena: desde que as nossas páginas passaram a apontar para ele, os rastreadores da OpenAI chegam lá a partir do nosso próprio site, quando antes o encontravam por meio de diretórios de terceiros.
Os agentes de programação pedem Markdown pelo nome. Se os desenvolvedores fazem parte do seu público, os agentes que eles rodam enviam Accept: text/markdown e usam o que recebem. A nossa central de ajuda foi para onde eles foram.
Se você tem um app GoodBarber no ar, a versão web dele já é a página que um assistente pode carregar e citar, e o GoodBarber MCP permite que um assistente ajude você a manter esse conteúdo atualizado. As páginas que os assistentes realmente leem são as que você já publica.
Perguntas frequentes
Isso vale para os apps criados com a GoodBarber?
Não diretamente: este artigo é sobre o nosso próprio portal. O que já vale para o seu app é a lição: os assistentes leem a página HTML que uma pessoa vê, então manter esse conteúdo atualizado é o que importa.
O site da GoodBarber pode ser lido por agentes de IA?
Sim. Desde setembro de 2026, cada página pública de goodbarber.com existe em Markdown, pelo cabeçalho Accept: text/markdown ou acrescentando .md ao seu endereço, e cada página HTML anuncia essa versão com um link padrão. O site também publica um llms.txt e um llms-full.txt, regenerados toda noite a partir das páginas, e cada página tem um link para eles.
Um agente de IA pode trabalhar com um app GoodBarber?
Sim, pelo GoodBarber MCP: um assistente como o Claude ou o ChatGPT pode se conectar ao seu app para ler e editar o conteúdo, publicar um artigo ou agendar uma notificação, com a sua aprovação. É um assunto diferente do deste artigo, e está descrito na página do GoodBarber MCP.
Os assistentes de IA leem as versões Markdown das páginas da web?
Não os assistentes voltados ao público geral, nos nossos logs de setembro de 2026. ChatGPT, Claude na web e Perplexity carregaram as nossas páginas HTML mais de 13.000 vezes em duas semanas, e as nossas páginas Markdown uma vez. Os rastreadores e os agentes de programação, esses sim, usaram o Markdown.
Servir Markdown ajuda no Google?
Não, e não é essa a intenção. As nossas páginas Markdown pedem aos mecanismos de busca que não as indexem e apontam de volta para a página HTML. O rastreador do Google nunca pediu uma delas.
Devo adicionar um llms.txt ao meu site?
Custa pouco, e os rastreadores de fato o leem quando as suas páginas apontam para ele. Nos nossos logs, ele é lido por rastreadores, diretórios e ferramentas de SEO, não pelos assistentes que respondem às perguntas das pessoas.